KI-Agenten verändern Kosten und Anforderungen an die IT. Wann sich lokale KI lohnt und wie Unternehmen die passende Infrastruktur finden.
Dienstag, 03 November 2026
KI-Infrastruktur · NVIDIA · Beratung
Nicht jede Anfrage muss in die Cloud. Und nicht jedes Team braucht einen KI-Supercomputer. Entscheidend ist eine Infrastruktur, die zu Ihren Anwendungen, Ihren Daten und Ihrem Betrieb passt.

Ein Coding-Assistent beantwortet Fragen. Ein KI-Agent kann darüber hinaus Code prüfen, Werkzeuge aufrufen, Ergebnisse bewerten und weitere Arbeitsschritte auslösen. Aus einer einzelnen Eingabe wird so ein Ablauf mit mehreren Modellaufrufen. Genau diese Entwicklung rückte NVIDIA auf der GTC Berlin am 21. Oktober 2026 in den Mittelpunkt: Agenten erweitern die Einsatzmöglichkeiten von KI – und erhöhen zugleich den Bedarf an Rechenleistung und kontrollierten Ausführungsumgebungen.
Ein LinkedIn-Beitrag von Thomas Kitzler greift die wirtschaftliche Seite dieser Entwicklung auf. Seine Beobachtung: Softwarehäuser und IT-Dienstleister hinterfragen steigende API-Kosten und wollen sensible Daten stärker unter eigener Kontrolle behalten. Das ist ein guter Anlass, die Infrastrukturentscheidung neu zu betrachten – aber noch kein pauschales Argument gegen die Cloud.
Die entscheidende Frage lautet nicht: Cloud oder eigene Hardware? Sondern: Welche Aufgaben sollten wo laufen? Für ein Studio mit vertraulichen Projektunterlagen kann die Antwort anders ausfallen als für ein Entwicklungsteam mit wechselnder Auslastung oder einen internen KI-Dienst für viele gleichzeitige Nutzer.
Bei einer Cloud-API wachsen die nutzungsabhängigen Kosten mit den verarbeiteten Ein- und Ausgaben. Eigene Hardware verschiebt die Kostenstruktur: Anschaffung oder Finanzierung, Strom, Kühlung, Software, Administration und Support treten an die Stelle eines Teils der API-Ausgaben. Ungenutzte Kapazität kostet trotzdem Geld.
Ein belastbarer Vergleich braucht deshalb einen definierten Workload: Welche Antwortqualität ist erforderlich? Wie schnell muss die erste Antwort erscheinen? Wie viele Anfragen laufen gleichzeitig? Und wie stark schwankt die Nachfrage? NVIDIA beschreibt in seinem Leitfaden zur Wirtschaftlichkeit von LLM-Inferenz, wie Latenz, Durchsatz und Spitzenlast die benötigte Infrastruktur und deren Gesamtkosten bestimmen.
Unsere Empfehlung: Vergleichen Sie nicht nur Kosten pro Token, sondern auch Kosten pro erfolgreich erledigter Aufgabe. Ein günstigeres Modell ist kein Gewinn, wenn sein Ergebnis mehr Nacharbeit verlangt. Bei regelmäßiger, gut ausgelasteter Nutzung kann lokaler Betrieb attraktiv werden. Für sporadische Aufgaben, Lastspitzen oder nur extern verfügbare Modelle kann eine API die sinnvollere Ergänzung bleiben.
Zwischen einem ersten lokalen Modelltest und einer unternehmensweiten KI-Plattform liegen unterschiedliche Anforderungen. In unserem Portfolio finden sich dafür mehrere Einstiegspunkte – nicht als austauschbare Leistungsklassen, sondern als Werkzeuge für unterschiedliche Aufgaben.
Entwickeln und erproben
Die kompakte Plattform mit GB10 Grace Blackwell und 128 GB gemeinsamem Systemspeicher eignet sich für lokale KI-Entwicklung, Inferenz und die Anpassung geeigneter Modelle. Ein Einstieg für Teams, die Anwendungen zunächst im eigenen Umfeld erproben möchten.
DGX Spark entdeckenKI und kreative Workflows
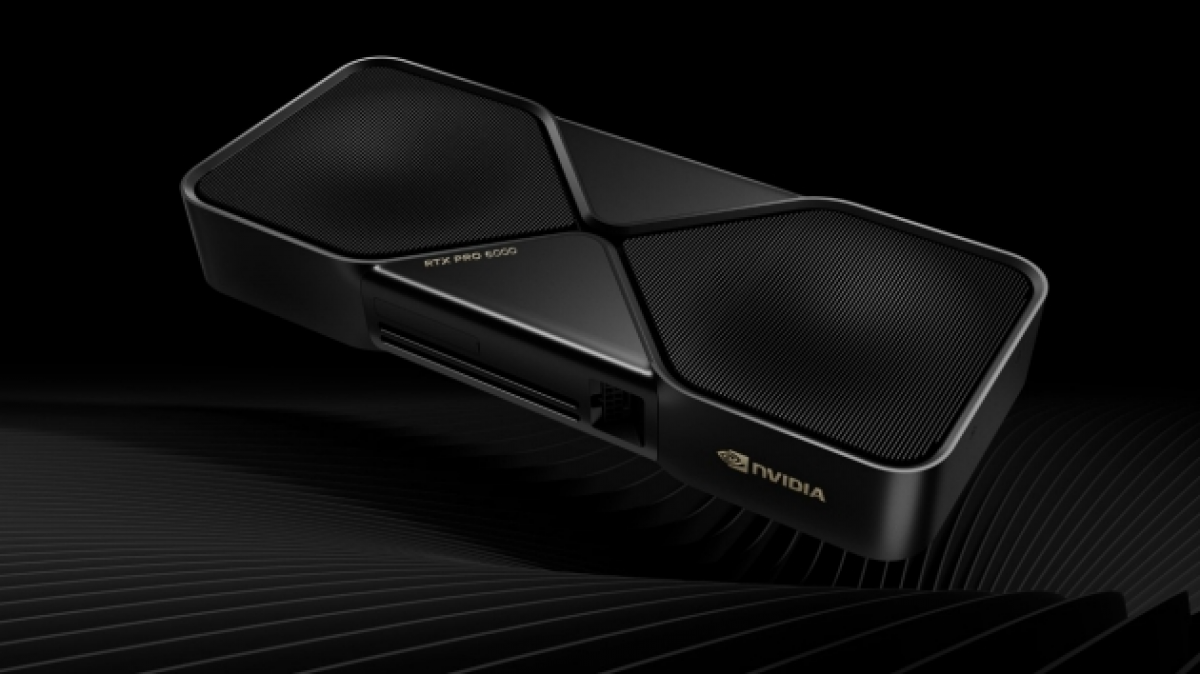
Die NVIDIA RTX PRO 6000 Blackwell Workstation-Edition bietet 96 GB GDDR7-Speicher mit ECC. Sie verbindet lokale KI mit professioneller Grafik und Rendering – interessant für Teams, die mehrere Aufgaben auf einer Workstation zusammenführen möchten.
RTX PRO 6000 kennenlernenGemeinsame KI-Dienste
Flüssigkeitsgekühlte Comino-Grando-Systeme und konfigurierbare Supermicro-Plattformen eröffnen Optionen für zentral bereitgestellte KI. GPU-Ausstattung, Speicher, Netzwerk und Kühlung werden auf Modell und Nutzung abgestimmt.
Comino Grando ansehen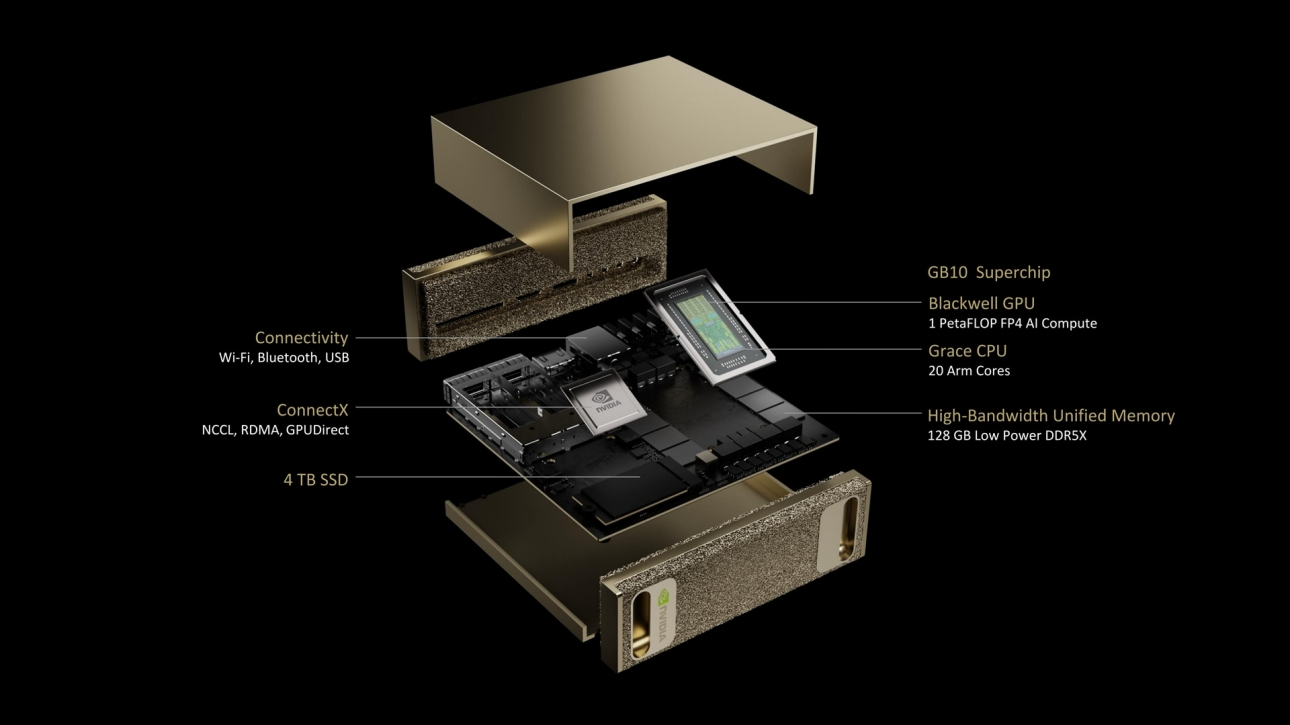
Die Speicherzahlen allein sind kein Leistungsvergleich. Gemeinsamer Systemspeicher und dedizierter GPU-Speicher unterscheiden sich im Aufbau. Außerdem beanspruchen neben den Modellgewichten auch Kontext, Zwischenspeicher und parallele Anfragen Ressourcen. Ob eine Plattform passt, zeigt deshalb ein Test mit dem vorgesehenen Modell, seiner numerischen Genauigkeit und der tatsächlichen Softwareumgebung. Hintergrund dazu liefern NVIDIAs Grundlagen zur Inferenzmessung.
Technische Details finden Sie bei NVIDIA zur DGX Spark und zur RTX PRO 6000 Blackwell. Weitere Serveroptionen stellen wir auf unserer Supermicro-Seite vor.
Der im LinkedIn-Beitrag genannte NVIDIA DGX B300 markiert eine andere Größenordnung: acht Blackwell-Ultra-GPUs, zehn Höheneinheiten und laut NVIDIA rund 14 kW Leistungsaufnahme. Das ist eine Rechenzentrumsplattform – kein allgemeiner Einstieg für jedes mittelständische Unternehmen.
Solche Systeme werden relevant, wenn Modellgröße, Trainingsbedarf oder hohe parallele Nutzung diese Ausstattung rechtfertigen. Dann gehören Stromversorgung, Kühlung, Netzwerk und Betriebsverantwortung zur Entscheidung. Dafür muss die Hardware nicht im Büro stehen: Wir unterstützen auch bei der Planung und Verlagerung von Infrastruktur ins Rechenzentrum.
Lokale KI bedeutet nicht automatisch, ein eigenes Sprachmodell von Grund auf zu trainieren. Ein möglicher Einstieg ist die Ausführung eines geeigneten vortrainierten Modells – die sogenannte Inferenz. Für interne Wissensassistenten kann zusätzlich Retrieval-Augmented Generation, kurz RAG, sinnvoll sein: Relevante Informationen werden aus freigegebenen Quellen abgerufen und dem Modell als Kontext bereitgestellt.
Damit lassen sich beispielsweise technische Dokumentationen, Produktionsrichtlinien oder Projektwissen für eine interne Suche erschließen. Ein denkbarer Studio-Workflow wäre ein Assistent, der Fragen zu Pipeline-Dokumentation beantwortet und die zugrunde liegenden Quellen nennt. Das ist ein Anwendungsszenario, kein Ersatz für fachliche Prüfung.
Bausteine dafür sind etwa NVIDIA NIM für die Bereitstellung unterstützter Modelle und der NVIDIA RAG Blueprint als Referenz für Anwendungen mit eigenen Daten. Welche Komponenten passen, hängt von Hardwareunterstützung, Modelllizenz, Anwendungsarchitektur und benötigtem Support ab.
Ebenso wichtig ist die Datenbasis. Dokumente und Medien müssen auffindbar, aktuell und mit passenden Zugriffsrechten verfügbar sein. Infrastruktur wie Qumulo auf Supermicro kann dabei die Dateiablage bilden. Sie ersetzt jedoch weder eine Such- oder Vektordatenbank noch das Berechtigungsmodell der KI-Anwendung.
Ein Modell auf dem eigenen Server kann die Kontrolle über Datenflüsse verbessern. Entscheidend bleibt aber die gesamte Anwendung: Ruft sie externe Dienste auf? Wo landen Protokolle? Welche Dokumente darf welcher Nutzer sehen? Und welche Aktionen darf ein Agent ausführen?
Das NVIDIA AI Red Team weist unter anderem auf unzureichende Zugriffsrechte in RAG-Systemen und Risiken bei der Ausführung generierten Codes hin. Begrenzte Berechtigungen, isolierte Ausführung und kontrollierte Verbindungen bleiben deshalb auch bei lokaler KI notwendig. Eine GPU im eigenen Rack ersetzt kein Sicherheitskonzept.
Die sinnvollste KI-Investition beginnt nicht mit einer Stückliste, sondern mit einem klaren Ziel. Welche Arbeit soll schneller oder besser werden? Welche Daten sind betroffen? Welche vorhandenen Ressourcen lassen sich nutzen? Und wer verantwortet den Betrieb?
Hier setzt die Technologieberatung von Escape Technology an. Wir betrachten GPU, CPU, Storage, Netzwerk und Software im Zusammenhang mit Ihrem Workflow. Unsere Erfahrung aus VFX, Animation, Games und Visualisierung hilft dabei, neue KI-Anforderungen mit bestehenden Produktionsumgebungen zusammenzubringen – statt eine isolierte Hardware-Insel aufzubauen.
Mit Installation und Konfiguration, der Integration vorhandener Infrastruktur und abgestimmten Supportleistungen begleiten wir auch die Schritte nach der Hardwareauswahl. Den konkreten Leistungsumfang für Ihr KI-Projekt klären wir gemeinsam mit Ihrem IT- oder Entwicklungsteam.
Unser Maßstab ist nicht die größtmögliche KI-Plattform, sondern die passende. Das kann eine kompakte DGX Spark sein, eine RTX-PRO-Workstation, ein zentraler GPU-Server oder eine Kombination mit Cloud-Diensten. Entscheidend ist, dass die Lösung Ihren Arbeitsalltag verbessert und sich technisch wie wirtschaftlich betreiben lässt.
Bringen Sie Ihren Anwendungsfall mit. Gemeinsam betrachten wir Anforderungen, vorhandene Systeme und passende Plattformen für Ihren Einstieg in lokale KI.


